 |
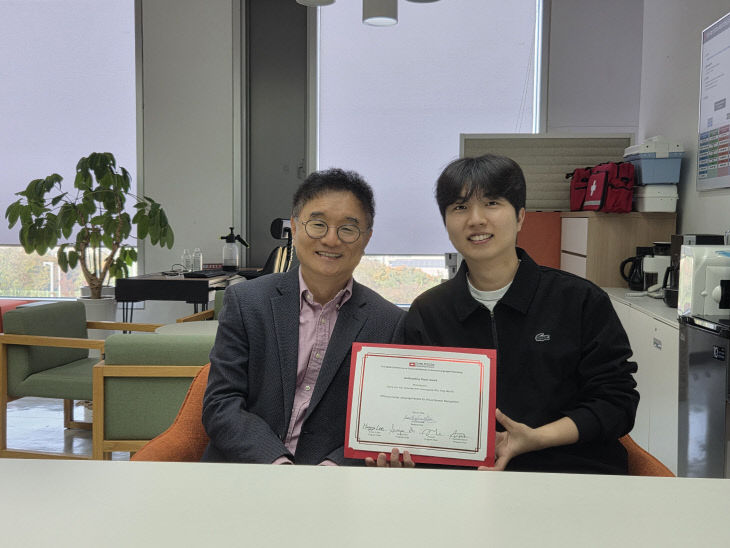
| KAIST 여정훈 박사후연구원(제1저자)과 노용만 교수(교신 저자). (사진=KAIST 제공) |
KAIST는 전기및전자공학부 노용만 교수 연구팀이 입술 움직임을 문자로 변환하는 '시각적 음성 인식(VSR)'의 정확도를 획기적으로 높인 AI 기술을 개발했다고 15일 밝혔다.
기존 AI는 문장을 첫 단어부터 순차적으로 생성해 앞부분에서 오류가 발생하면 뒷문장까지 연쇄적으로 틀리는 한계가 있었다. 유사한 입모양을 가진 다른 발음을 구별하기 어렵기 때문이다.
연구팀은 이를 극복하기 위해 문장의 빈칸을 반복해 채우는 '확산 대형 언어 모델(DLLM)'을 도입했다. 퍼즐에서 모양이 뚜렷한 조각부터 맞춘 뒤 주변을 채우듯, 입모양이 명확한 단어를 먼저 인식하고 헷갈리는 부분은 앞뒤 문맥을 종합해 해독하는 방식이다. 또한 영상 길이를 바탕으로 여러 문장 길이를 추정한 뒤 가장 신뢰도 높은 결과를 선택하도록 설계해 정확도를 극대화했다.
그 결과 433시간 분량의 입모양 영상 데이터셋(LRS3) 실험에서 단어 오류율 19.4%를 기록했다. 이는 동일 조건의 기존 기술 중 가장 낮은 수치다.
이번 기술은 소음이 극심한 산업 현장의 작업자 소통이나 청각장애인·난청인을 위한 대화 보조 기기에 폭넓게 활용될 수 있다. 연구팀은 향후 모델을 경량화해 웨어러블 기기나 로봇에서 인터넷 연결 없이 실시간 작동하는 '물리적 인공지능(Physical AI)'으로 고도화할 계획이다.
한편 여정훈 박사후연구원이 제1저자로 참여한 이번 연구는 자연어 처리 분야 국제학술대회 'EMNLP 2026'에서 우수논문상을 수상했다.
임병안 기자
중도일보(www.joongdo.co.kr), 무단전재 및 수집, 재배포 금지